TL;DR
コーディングエージェント用途でサクサク動く LLM が欲しかったので量子化モデルを作りました。Deepseek Harness で運用してますがそこそこ動きます。 llama.cpp に対応してますので興味がある方はお試しください。
- 学習
- Qwen3.8-3.6-27B-blend を参考にマージモデルを教師として QAT (3値)
- 性能
- RTX 4000 Ada (20 GB) で 56.8 tok/s (MTP 有効)
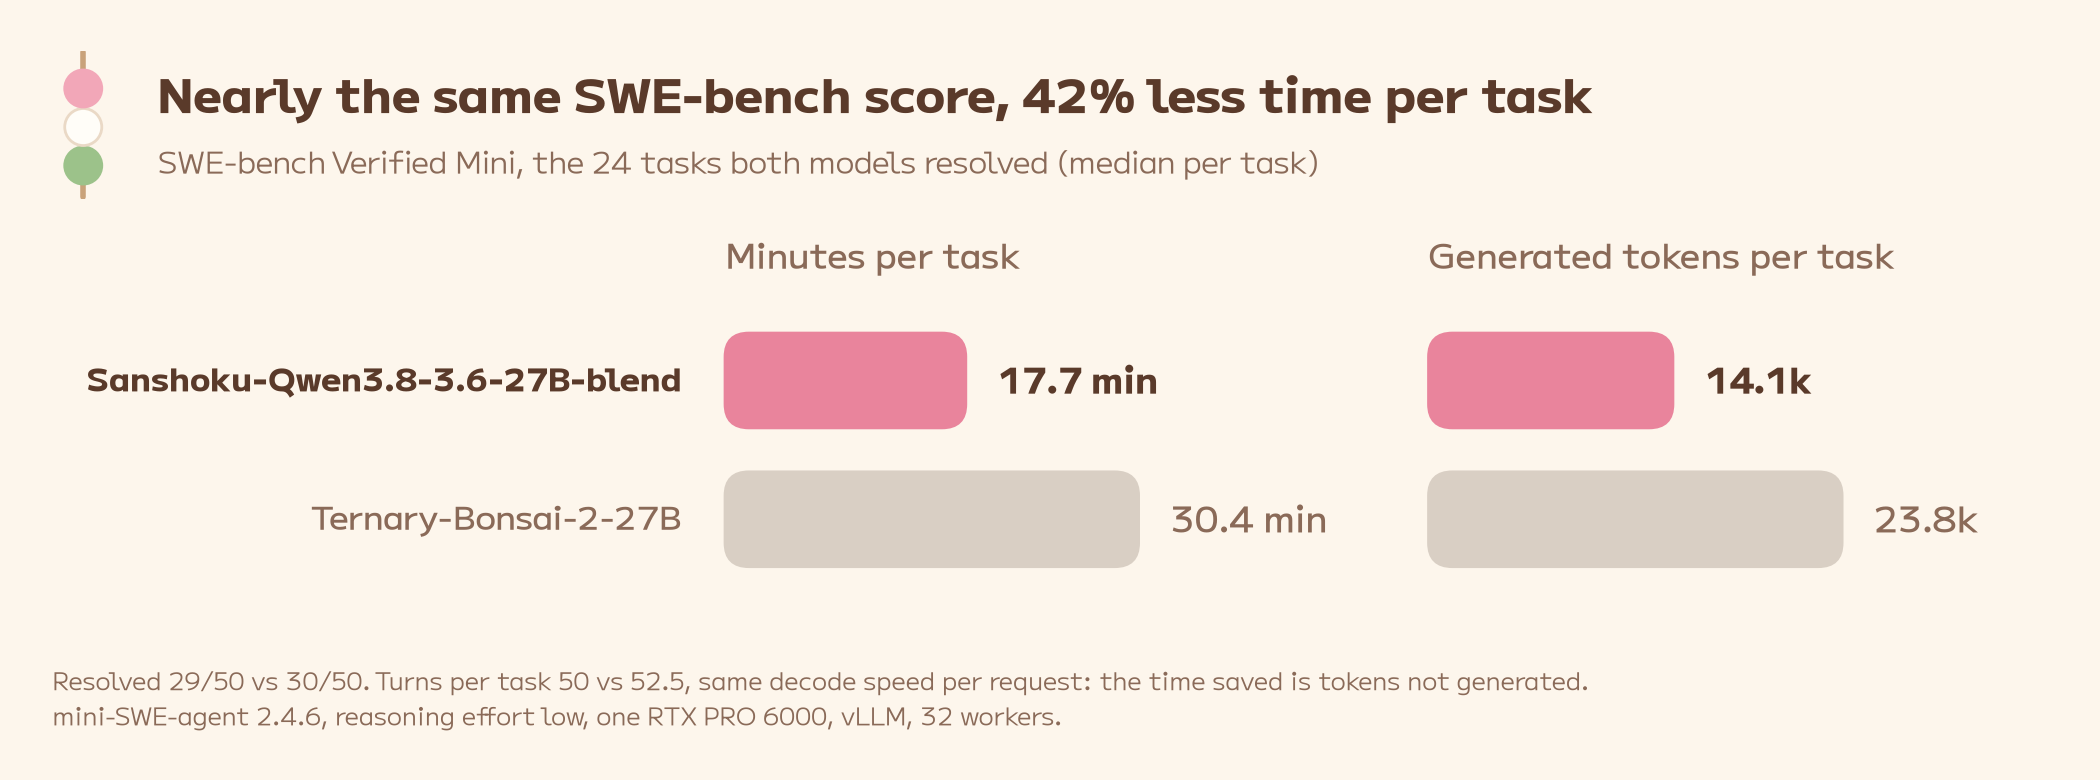
- SWE-bench Verified は 58.0% で Ternary-Bonsai-2-27B (60.8%) と同程度
- 1タスクあたりの時間は約4割短い (ループ抑制のチューニングを入れている)
- 単発の推論や知識問題は Ternary-Bonsai-2-27B に劣る
Claude Code と Codex のパワーで一連の実験を進めました。1 GPU (B300) でも最適化すれば QAT は結構行けるなという印象です。
Qwen3.8-27B と Qwen3.6-27B のマージ
この組み合わせのモデルマージは JetBrains が Qwen3.8-3.6-27B-blend として公開していて、今回参考にしています。 もともと Qwen3.8 は Think が長くなりがちという性質があり、その対策として Qwen3.6 とマージすると良いというもの。ただ量子化すると長考が再発するので結局別の対策を入れました。(後述)
マージは全テンソルを float32 で w36 + 0.5 * (w38 - w36) と線形補間したものです。
初期化は少し工夫しており、2 つの教師の中間点のうち、3値量子化した場合の誤差が小さくなるように係数を調整しました。
素の丸めと比べて、重みの相対誤差は 0.44 から 0.28〜0.40 に下がっています。
学習方法
- 量子化
- 128 個の重みで1つのスケールを共有し、そのグループ単位で3値とスケールを決定 (BitNet b1.58)
- 3値は、Qwen3.6 と Qwen3.8 の値が作る区間のうち最も近い値を選んで初期化 (区間丸め)
- attention の k/v と linear attention 側の alpha/beta は F16 (全体の約 0.7%)
- 学習
- 3値への丸めを straight-through estimator で QAT
- TopK = 32 トークンを蒸留に使用
- MTP も同時に学習
- 学習データ
- 約 1B トークン
- コード・日本語・英語コーパス + エージェント軌跡 + 数学
学習の流れは以下のとおり:
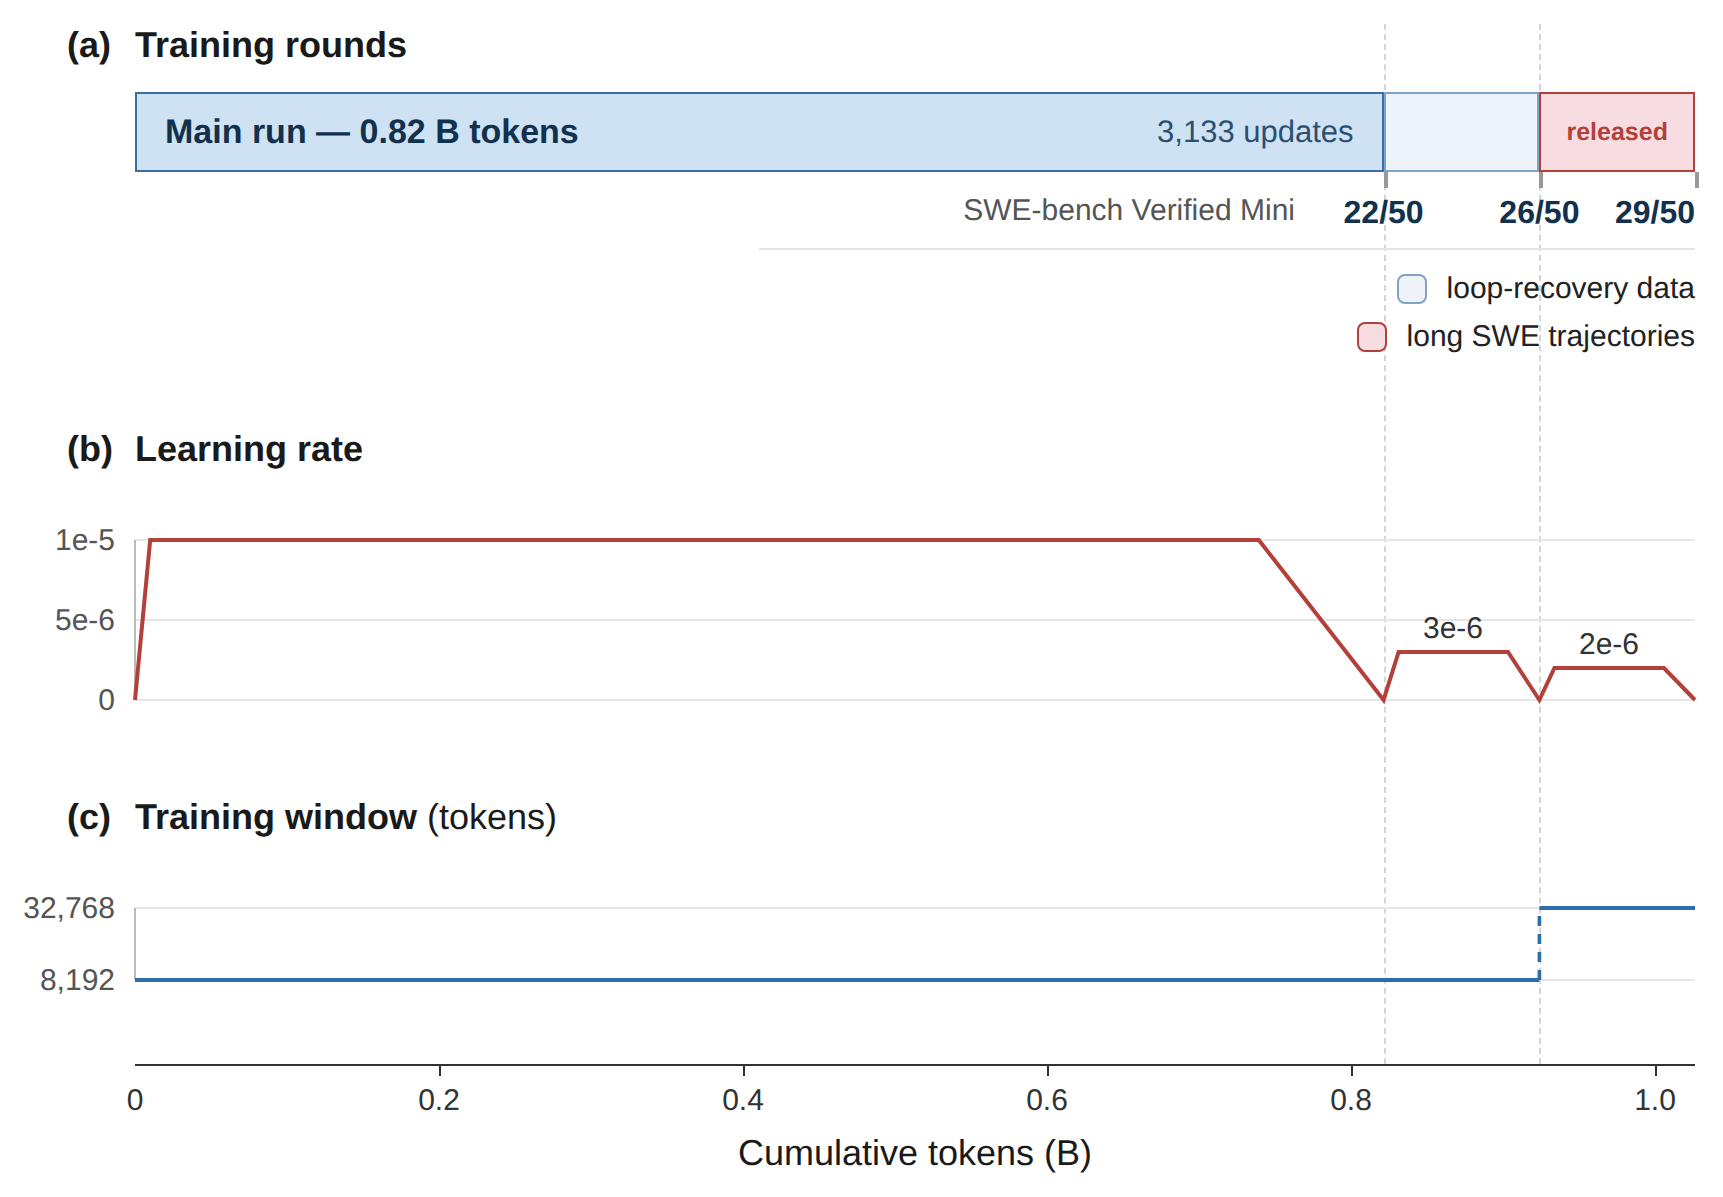
後半は pi で実際に使ってみて挙動を確認しつつ学習方法を調整しています。
自前のコードで学習しており、PyTorch と Triton, flash-linear-attention を使用しています。B300 × 1 台の構成に特化して最適化することで速度を得ています。
学習の1ステップは当初 83 秒かかっていましたが、FP8 化やカーネル融合の工夫を入れて 28.5 秒になりました。1秒あたりおよそ 9,200 トークンで、1B トークンなら止まらずに回して31時間ほどになります。
教師の確率分布は、別途生成してキャッシュしておく構成にしています。生成は毎秒 25,700 トークンほど。
ループ抑制
いちばん時間を使ったのはループへの対策でした。
エージェントは、コマンドを1つ出す応答 (ターン) とその結果を交互に重ねて進みます。ターンが同じコマンドの繰り返しから抜け出せなくなるのがループで、前のターンの文章をそのまま書き写すのをコピーと呼びます。
3値に蒸留したモデルは、教師にした元のモデルよりループしやすいという傾向があります (Pipis et al. 2025)。一通り学習を終えた時点のモデルは、SWE-bench Verified から50問を抽出した軽量評価セット (Mini) で 22/50。そのうち 14 本 (2つ以上のコマンドが周期的に回るものも数えると 16 本) がループでした。
ループの抜けにくさを測る小さなテストを作り、繰り返しが起きたときの文脈を集めたデータと、抜け出すトークンの確率が繰り返すトークンより高くなるようにする損失 (FOCUS & RePAIR) を加えることで対策しました。
最初の試行でループは 0 本になりましたが、抑制が強すぎて、抜け出すトークンと繰り返すトークンの確率比の対数が 11 nats (1 nat で e 倍) まで開きました。 正解数は 23/50 で横ばいでしたが、提出したうちの正解は 59% に落ち、評価スコアも悪化。
そこで必要なマージンを 4 nats に上げ、満たされたら勾配が止まる形に変え、思考の中の繰り返し用のデータを足したところで 26/50・ループ 0 本になりました。
損失として使うのはループが始まる位置の1点における、抜け出すトークンと繰り返すトークンの確率の比だけです。ループした文脈では教師自身が繰り返しを続けてしまう (Mismatch Matters) ので、教師の答えは目標に使えないという問題があります。代わりに「抜け出す側がマージン (4 nats) だけ高い」を目標にして、届いていなければその差分を損失とします。
計算は次の2行だけです (実際は複数位置をまとめて処理しています)。
# ループ開始位置で、抜け出す側 (escape) と繰り返す側 (repeat) の logit の差を取る。
# softmax の分母が消えるので、これがそのまま確率比の対数 (nats) になる
difference = (h * (w_escape - w_repeat)).sum(-1) / temperature

# margin に届いていなければ差を損失とする
loss = F.relu(margin - difference).mean()
データのほうは、思考の中の数文のかたまりを数回繰り返させた文脈を作ります。同じ文を繰り返しても、直前の文字が違えばトークナイザの切り方が変わるので、トークン列が同じになるとは限りません。そこで実際にプロンプトへ流し込んだあとにトークン単位で周期を確かめ、壊れていたらそのサンプルは捨てます。試作では3分の2ほどがこの理由で落ちました。
次に出たのがコピーでした。会話の履歴に自分の過去の思考がそのまま残るので、ラウンドを重ねるうちに長い文脈でのコピーが増え、32〜48k トークンではターンの 66% が前のターンのコピーになっています。これを抑えると、今度は 1 ターンの思考が 7 倍に伸びて 18/50 まで落ちました。
試行錯誤の末、SWE-bench Verified Mini で 29/50、ループが 0 本だった時点の重みが最良だったので、これを公開しています。失敗の多くは誤ったパッチではなく時間切れで、提出したうちの 76% は正解しています。
評価
3モデル (今回のモデル、Ternary-Bonsai-2-27B、Qwen3.8-27B BF16) を同じ評価ツール・同じ設定 (vLLM、RTX PRO 6000 を1台、effort low) で測りました。 結果はモデルカード にまとめています。
Bonsai 越えを目指していましたが、全体としては負けています。フルのベンチマークは最後に実行しましたが、調整のために途中でも網羅的なベンチを実行すべきでした。 SWE は同程度に追い付きましたがデータの工夫が必要な気がしています。
計算環境 (Nebius)
Nebius の GPU の時間借りを使用。学習用の B300 が $4.30/h、評価用の RTX PRO 6000 が preemptible で $0.95/h でした。preemptible はよく落ちるので復帰の工夫は必須。
Claude Code の CronJob で監視させると予期せぬエラーから自動復帰できて便利でした。
おわりに
ほどほどの結果は得られたので良かったです。
手元の GPU (RTX 4000 Ada) で快適に動くモデルがほしいというのが出発点でしたが、今思うと GPU が買えるくらいのクラウド費用がかかっているような…?
まだ試したいことは色々あるので、資金的な余裕ができたら試していこうと思います。
参考文献メモ
- Wait, Wait, Wait… Why Do Reasoning Models Loop? (Pipis et al. 2025)
- Learning to Break the Loop (Xu et al. 2022)
- FOCUS & RePAIR (ICML 2026)
- Circular Reasoning / LoopBench
- Mismatch Matters (2608.09836)
- Revisiting DAgger in the Era of LLM-Agents (2605.12913)
- Conversational Inertia (2602.03664)
- SWE-AGILE (2604.11716)
- Revisiting On-Policy Distillation (2603.25562)
- Short Data, Long Context (2604.06070)
- Quantized Reasoning Models Think They Need to Think Longer (2606.00206)
- Danger of Overthinking (2502.08235)
- Flat Score, Amplified Failures (2607.27275)
- BitNet b1.58 (2402.17764)
- Estimating or Propagating Gradients Through Stochastic Neurons (Bengio et al. 2013)
- DeepSeek-V3 (2412.19437)